我用 n8n 搭了结合去重、核验、写日报的情报编辑部
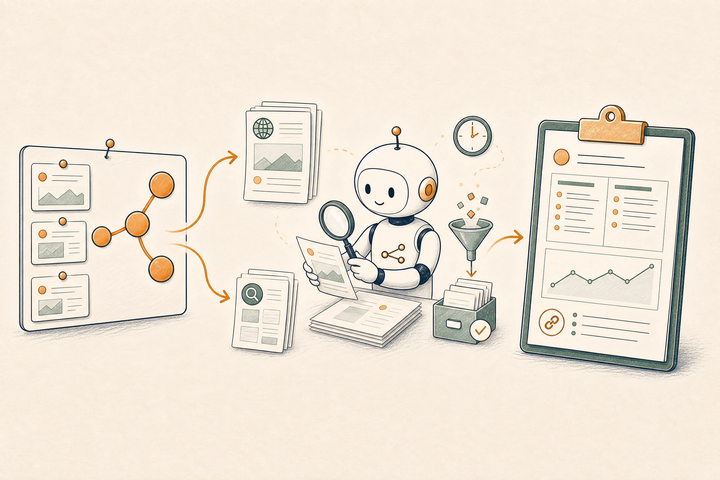
很多人第一次做“新闻自动化”时,脑中只有一个画面:每天搜几个关键词,把链接发到群里。 但真正跑过一段时间就会发现,难点根本不在“搜到新闻”。难点在于你会收到大量你并不想看的东西:同一篇稿子被不同网站转载、搜索结果里混进无关广告、两年前的旧新闻因为 SEO 又排到前面、标题看起来相关但正文完全不是那家公司,最后你还要手工判断哪些值得读、哪些根本不该出现。 如果自动化只是把更多链接塞进飞书,它不是帮你省时间,而是在更快地制造噪音。 所以这份 n8n 工作流没有把“搜索”当成终点,而是把它设计成一条完整的信息编辑流水线: 先由人定义什么值得关注;再让不同第三方搜索源帮我们广泛召回;接着用代码和长期记忆去重;再提取正文交给 AI 做相关性与时效审查;最后仍用规则拦住不合格内容,才把一份可以追溯来源的日报发出去。 它更像一间小型行业情报编辑部,而不是一个“会搜新闻的机器人”。 这篇文章会按工作流实际运行顺序,把每个节点都讲明白:它在做什么、为什么必须放在这里、如果不做会出什么问题,以及这种方法还能迁移到哪些领域。 先看全流程:一份日报是怎样被编辑出来的 把整个工作流放进“编辑部
最近更新 2026.08.27
27 8月 2026